1. なぜ「行動データ」が必要なのか?
「属性データ」だけでは、会員一人ひとりの“実像”を捉えるには限界があります。属性とは、氏名、職種、所属施設、専門領域、年齢層など、いわば「外から見える情報」に過ぎません。これらは会員の“背景”を理解する手がかりにはなりますが、「どんな情報を求めているのか」「どんな動機でアクセスしているのか」といった“内面のニーズ”までは語ってくれません。
そのギャップを埋めるのが、「行動データ」です。実際のアクセス履歴、閲覧時間、クリックパターン、ページ遷移の流れ、あるいは資料請求やフォーム入力といった具体的なアクションのログ──これらは、ユーザー自身が意識せずとも残していく“無意識の発言”のようなものです。以下に、その意義と役割を掘り下げてみましょう。
1-1. 行動は「無意識の意図」を物語る
医師や薬剤師、コメディカルといった医療従事者は多忙で、限られた時間のなかで必要な情報にたどり着こうとします。だからこそ、その行動パターンには「いま何が必要なのか」「どこで迷っているのか」といった意図が反映されやすいのです。
たとえば、製品Aのページを繰り返し閲覧したあとに、Q&Aや副作用情報へ遷移している場合、それは「処方を検討しているが安全性が気がかり」といった心理を推測する材料になります。このような“行動の痕跡”は、属性情報では見えない深層のニーズに近づく手がかりです。
1-2. 時間軸とともに見えてくる「変化」
行動データは“時系列で観察できる”という強みも持ちます。たとえば、ある医師が1カ月前までは特定疾患の基礎情報ばかりを見ていたのに、最近では治療薬の比較ページを多く見ているとしたら──そこには“学習フェーズから処方検討フェーズへの移行”という変化が現れているかもしれません。
また、曜日や時間帯によるアクセス傾向も示唆的です。時間帯別の利用パターンが見えてくると、メール配信やコンテンツ更新のタイミング最適化にもつながります。
1-3. 「関心の優先順位」が読み解ける
一度のアクセスではなく、継続的に行動データを蓄積することで、ユーザーごとの“関心の強弱”も把握できます。たとえば同じ疾患情報でも、基本ページに数秒しか滞在しない会員と、関連する複数ページを時間をかけて熟読する会員がいれば──この行動量の違いは、興味の差と読み取れます。
さらに、複数コンテンツをどう“組み合わせて”見ているかによっても、ニーズの複雑性や学習ステージが見えてきます。これは属性では測れない“今この瞬間の興味関心”の優先順位を明らかにする手がかりになります。
1-4. 行動データ活用における倫理的配慮
医療従事者の行動ログを活用する際には、プライバシーと倫理への配慮が不可欠です。特に製薬企業が医師の行動を追跡する場合、以下の原則を遵守すべきです。
行動データ活用の倫理原則
| 原則 | 内容 | 実装例 |
|---|---|---|
| 透明性 | データ収集と利用目的を明示 | プライバシーポリシーでの明記、初回ログイン時の説明 |
| 同意取得 | オプトイン方式での承諾 | クッキー同意、詳細分析への個別同意 |
| 匿名化 | 個人を特定できない形での分析 | 統計処理、ID化、セグメント単位での活用 |
| 用途制限 | サービス改善以外に使用しない | マーケティング以外での流用禁止、第三者提供の制限 |
| セキュリティ | データ漏洩防止の徹底 | 暗号化、アクセス制限、監査ログ |
製薬業界では透明性ガイドラインへの準拠も求められるため、行動データの取得・活用については社内のコンプライアンス部門と連携することが重要です。
このように、行動データは単なるクリック履歴にとどまらず、「誰が、いつ、なぜ、それを見たのか」を読み解くためのストーリー素材です。次章では、この行動ログと会員属性をかけ合わせることで、どのように“人物像”が立ち上がってくるのかを具体的に見ていきます。
2. 会員属性 × 行動ログ のかけ合わせ
デジタル上で蓄積される「行動ログ」は、単体でもユーザーの興味関心や課題を読み解く強力な素材です。しかし、誰がそれを行ったのかという“文脈”がなければ、見えてくるのは平均化された漠然とした傾向にとどまってしまいます。一方で、会員登録時に取得される「属性データ」は“誰か”を明らかにするものの、“何をしたのか”までは教えてくれません。
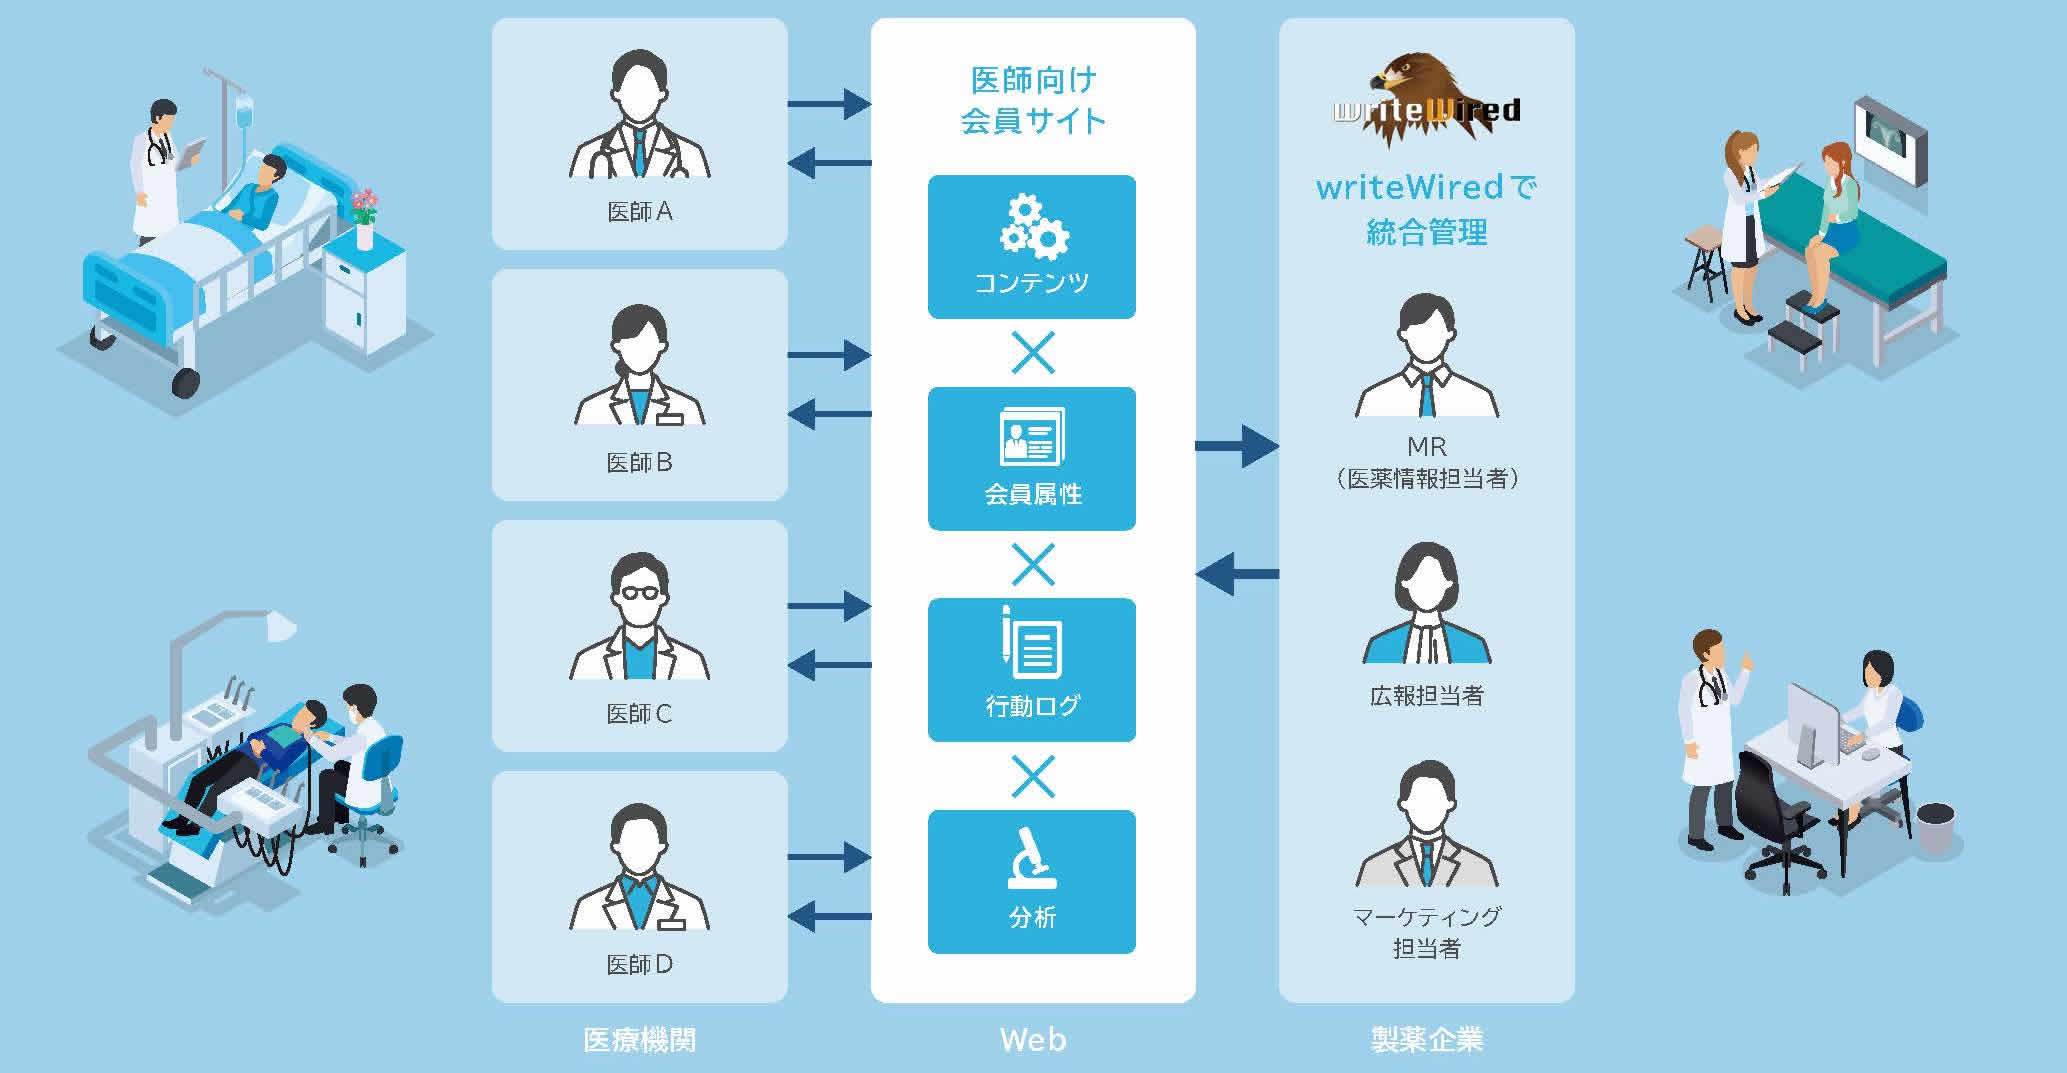
この2つを掛け合わせることで、個別の行動を人物像として結びつけることができ、精緻な理解とパーソナライズ施策に活かすことが可能になります。
2-1. 「行動に意味を与える」のが属性情報
ある会員が「ある動画を最後まで視聴した」とします。これだけを見ると、単なる完了率のデータです。しかし、視聴者が“若手の勤務医”であるのか、“ベテランの開業医”なのかによって、その行動の意味は大きく異なります。前者であれば「初学者としての学習ニーズ」、後者であれば「処方判断の最終確認」かもしれません。
このように、属性情報は「その行動は、誰によるものか」という解釈軸を与えることで、行動の背景や目的をより明確にします。
2-2. 属性 × 行動 によるセグメント設計
属性と行動をかけ合わせた分析を行うことで、単なる「属性別」や「行動パターン別」では見落とされがちな“行動の質”が浮かび上がります。
たとえば、以下のような複合的なセグメントが設計できます:
- 「開業医」×「製品詳細ページへの高頻度アクセス」
- 「勤務医」×「疾患解説動画の視聴+FAQページ閲覧」
- 「薬剤師」×「副作用情報と投与法資料を交互に確認」
- 「コメディカル」×「平日夜間の継続ログイン+学習系コンテンツ」
こうしたセグメントに対して、それぞれ異なる情報提供戦略やリコメンデーションが可能になります。
2-3. 実践的なセグメント分析の手順
具体的なセグメント分析は、以下の手順で進めます。
セグメント分析の5ステップ
| ステップ | 作業内容 | 手段の例 | アウトプット |
|---|---|---|---|
| 1. データ抽出 | 会員属性とログデータの結合 | 会員IDを鍵にした結合処理 | 統合データセット |
| 2. 探索的分析 | 集計・可視化でパターンを探す | 時間帯×属性のクロス集計、ヒートマップ | 仮説の種 |
| 3. セグメント定義 | 差が見られる軸で分類 | クロス集計、クラスタリング | セグメント一覧 |
| 4. 検証 | 各セグメントの行動特性を数値で確認 | 期間を変えた再集計、A/Bテスト | 再現性の確認 |
| 5. 命名・文書化 | わかりやすい名称とプロファイル作成 | ドキュメント化 | セグメント定義書 |
セグメントの定義は、たとえば次のような型に落とし込みます。数値の欄は、自社のログを集計して埋めます——ここに載せるべきなのは想像ではなく、実測値です。
セグメント定義の型(記入前の雛形)
- 属性:職種・年代・診療科など、分類に使った属性条件
- 行動:時間帯の偏り、1回あたりの滞在、閲覧の組み合わせなど、実測した特徴
- 規模:該当会員数と全体に占める割合、アクティブ率
- 名称:「深夜学習型」など、行動が想像できる呼び名
規模と実測値が入って初めて、施策の優先順位を議論できる材料になります。
2-4. マトリクスで発見する“見落としがちな層”
属性 × 行動のマトリクスを活用することで、“意外なグループ”の存在にも気づくことがあります。
たとえば、普段あまり活発にログを残さないと見なされていた職種の中に、特定の情報に対して極めて深い関心を持ち、繰り返しアクセスしている小集団が見えてくることがあります。このような“見えにくい重要層”の発見は、定量データのクロス分析によって初めて可能になります。
同様に、「開業医=夜間アクセス」「勤務医=平日日中」といったステレオタイプを超えて、個々の生活リズムやニーズに即した対応が見えてくるのも、このかけ合わせ分析の利点です。
2-5. プロファイルの「多面性」を把握する
属性データはあくまで“名札”でしかなく、人は一つのカテゴリに収まる存在ではありません。「内科医であり、薬剤師とも密に連携している」「勤務医でありながら地域医療に関心がある」など、実際のユーザー像は多面的です。
行動ログと組み合わせることで、このような“表には出ない側面”が可視化され、ユーザーごとの立体的なプロファイル構築が可能になります。
2-6. よくある分析の失敗パターンと対策
データは揃っているのに解釈を誤る、ということが実務では起こります。
典型的な分析の落とし穴
| 失敗パターン | 問題点 | 対策 |
|---|---|---|
| 相関を因果と誤解 | 「夜間アクセスする層は反応が良い」→夜間アクセスが原因とは限らない | 第三の要因を探る、実験設計で検証 |
| サンプルサイズ不足 | ごく少数の行動から全体を語る | 件数を確かめてから一般化する |
| 生存者バイアス | アクティブ会員のみ分析し、離脱者を無視 | 離脱分析も並行実施 |
| 過剰な細分化 | 運用できない数のセグメントを作る | 運用チームが回せる数に絞る |
| データの鮮度無視 | 古いパターンで今を語る | 直近のデータを重視し、集計期間を明記する |
データ分析は「見たいものが見える」リスクがあるため、常に批判的視点を持つことが重要です。
このように、会員属性と行動ログのかけ合わせは、単なる分類を超えた“意味のある人物像”を描き出すための基本手法です。次章では、そこから導き出される仮説ペルソナの設計について掘り下げていきます。
3. 仮説ペルソナをどう設計し、どう使うか?
「仮説ペルソナ」は、会員属性と行動ログの分析をもとに構築される“象徴的なユーザー像”です。ユーザー全体を代表するのではなく、特定の関心・行動パターンを持つ一群を象徴的に表現するもので、コンテンツ設計やコミュニケーション施策の基点となる重要な道具です。
本章では、その設計手順と活用方法について、実務に即した視点で掘り下げていきます。
3-1. 仮説ペルソナとは「仮定に基づく解釈モデル」
一般的な“ペルソナ設計”は、アンケートやインタビューから導かれることが多い一方、「仮説ペルソナ」は主に行動ログや属性データといった定量情報をもとに構築されます。そのため、客観的データに基づいた論理的仮定でありながら、「人間像としてのリアリティ」を伴う必要があります。
例えば、以下のような形で仮説ペルソナを設計します:
仮説ペルソナA
属性:40代・開業内科医・都市部勤務
行動特性:製品情報ページを繰り返し閲覧/夜間アクセスが多い/FAQ・副作用情報も確認
解釈:日中は診療が忙しく、処方判断は夜に行う。新しい治療選択肢に関心があるが、安全性にも慎重。
このように、定量的な傾向を背景としながら、「人としての動機・事情・行動背景」を仮定し、物語性をもたせることが設計の鍵となります。
3-2. 仮説ペルソナ設計のプロセス
仮説ペルソナを設計するためには、以下のような手順が有効です:
- セグメント抽出:職種×行動パターンなどで特定グループを抽出する
- 共通点の明文化:行動傾向・アクセス傾向・関心領域などの共通要素を整理
- 人物像への翻訳:どのような生活背景・ニーズ・制約条件を持っているかを仮定
- ニーズの言語化:そのペルソナが“今”求めている情報、解決したい課題を記述
- ストーリー化:1日の行動や医療現場での役割に絡めた描写を加えるとより有効
このプロセスにおいて重要なのは、「仮説であること」を忘れず、過信しないことです。実際のアクセス結果やアンケートとの照合を通じて、定期的なアップデートが必要です。
3-3. ペルソナシート作成のテンプレート
実務で使いやすいペルソナシートのフォーマットを以下に示します。
ペルソナシート構成要素
| セクション | 記載内容 | 目的 |
|---|---|---|
| 基本情報 | 名前(仮名)、年齢、職種、勤務形態、専門領域 | 一目で誰かを把握 |
| 行動データ | アクセス頻度、時間帯、滞在時間、閲覧コンテンツの傾向 | データ的裏付け |
| 一日の流れ | 典型的な1日のスケジュールと情報接触タイミング | 生活文脈の理解 |
| 課題とニーズ | 困っていること、知りたいこと | 施策の方向性 |
| 情報収集スタイル | デバイス、好む形式、情報源 | コンテンツ設計 |
| 引用(実際の声) | アンケートやヒアリングで得た生の声 | リアリティ付与 |
| 対応施策 | このペルソナに最適なアプローチ | アクション指針 |
記入例:「深夜学習型」を代表する架空の一人
- 基本情報:40代、開業内科医、地方都市
- 行動データ:夜間アクセス中心、疾患解説と症例動画を組み合わせて閲覧(頻度・滞在は自社ログの実測値を記入する)
- 一日の流れ:日中は外来で埋まり、夜が自己学習の時間
- 課題:新しい治療法をキャッチアップする時間が取れない
- 情報収集スタイル:PC中心、要点がまとまった記事を好む
- 引用:(未記入。アンケートやヒアリングを実施してから、実際の声を入れる)
- 対応施策:夜間のメール配信、要約記事の強化
引用欄を空のまま運用し始めることには意味があります。空欄は「まだ裏取りをしていない」という状態の可視化であり、それらしい架空の声で埋めた瞬間に、ペルソナは検証不能な作文になってしまいます。
3-4. ペルソナは何に使うのか?
設計した仮説ペルソナは、以下のような具体的な施策に活用されます:
- コンテンツ設計:どのテーマ・切り口・形式が響くかを見極める
- メール配信のパーソナライズ:誰に、いつ、どんな件名・内容で届けるべきか
- レコメンドエンジンの強化:特定ペルソナに最適なコンテンツや資材を優先表示
- KPI設計と効果測定:ペルソナ別の行動変化・閲覧完了率などをトラッキング
たとえば「仮説ペルソナB(勤務薬剤師、昼休みアクセス、Q&A閲覧中心)」に向けた施策では、昼の時間帯に簡潔な安全性解説メールを配信する、といった具体的対応が導かれます。
3-5. ペルソナ活用の効果測定
ペルソナを作ること自体が目的ではなく、「ペルソナに基づく施策が成果を生んだか」を測定することが重要です。
ペルソナ別KPIの考え方
| ペルソナタイプ(例) | 見るべき指標 | 測り方 |
|---|---|---|
| 深夜学習型 | 夜間帯のコンテンツ完読状況 | 時間帯別のエンゲージメント集計 |
| 昼休み情報収集型 | 昼の時間帯のセッション数の推移 | 時間帯別アクセス分析 |
| 慎重検討型 | 安全性情報ページの閲覧の深さ | 滞在時間・スクロールの計測 |
| 若手学習意欲型 | 学習系コンテンツの完了状況 | 完了ログの集計 |
目標値は、この表にはあらかじめ書けません。自社の現状値を測ってから、そこを基準に決めるものだからです。四半期ごとに各ペルソナの行動変化を追跡し、施策の有効性を検証します。
3-6. チームで「共通言語」として活用する
仮説ペルソナは、個人で抱えておく分析の結果ではなく、チーム全体で共有する“共通言語”として活用することに価値があります。
たとえば、Web担当、マーケティング、コンテンツ制作、営業支援などの関係者が「この施策はペルソナA向けですか?B向けですか?」といった会話を日常的に交わせるようになれば、判断の軸がぶれず、施策の一貫性も高まります。
3-7. ペルソナの継続的アップデート
ペルソナは「作って終わり」ではなく、定期的に見直す必要があります。医療環境、製品ライフサイクル、会員の成熟度によって行動パターンは変化するからです。
ペルソナ更新サイクル
| タイミング | 更新内容 | 理由 |
|---|---|---|
| 四半期ごと | 行動データの数値更新 | トレンドの変化把握 |
| 半期ごと | ニーズと課題の見直し | 施策効果の反映 |
| 年次 | ペルソナの統廃合・新設 | 会員構成の変化対応 |
| 重大イベント時 | 臨時見直し | 新製品発売、ガイドライン改訂など |
更新履歴を残すことで、「なぜこのペルソナが生まれ、どう変化したか」の記録が組織知になります。
仮説ペルソナは、会員理解を“人間の姿”に落とし込む翻訳装置であり、あらゆる施策の「ターゲット設定の精度」を向上させる起点です。次章では、データを人の像に変える本質的な考え方を見ていきます。
4. データを“人の像”に変える力
デジタル施策の現場は、アクセスログやクリック数、閲覧率、離脱率といった“データ”に囲まれています。しかし、数値を眺めているだけでは、ユーザーの実態は見えてきません。そこに「誰が」「なぜ」「どんな文脈で」行動したのかという物語性を与えることで、データは初めて“人の像”へと変わります。
この章では、無機質なデータを“理解できるユーザー像”へと翻訳する力について掘り下げていきます。
4-1. 数値を超えて「行動の背景」を探る
たとえば「あるページの閲覧数が急増した」という事実。それは一見すると“人気ページの発見”ですが、そこに「誰がアクセスしたのか」「なぜこのタイミングで注目されたのか」を重ね合わせることで、まったく異なる意味を持ちます。
・新製品を処方検討している開業医が多く見ていた?
・他社製品の安全性問題が報道された直後?
・MRとの面会後にアクセスしているケースが多い?
このように、行動の“背景文脈”を想像することで、数字に人の息づかいが宿ります。
4-2. 文脈を読み解くための「5W1H分析」
データに文脈を与えるには、ジャーナリスティックな5W1H思考が有効です。
データに問いを立てるフレームワーク
| 問い | 分析視点 | 使用データ | 得られる洞察 |
|---|---|---|---|
| Who(誰が) | 属性セグメント別の行動差異 | 会員属性×行動ログ | どの層がアクティブか、意外な層の発見 |
| What(何を) | 閲覧コンテンツの傾向 | ページビュー、DL数 | 関心テーマ、情報ニーズ |
| When(いつ) | 時間帯・曜日・季節パターン | タイムスタンプ分析 | 最適な配信タイミング、生活リズム |
| Where(どこで) | デバイス・場所(推定) | UA、デバイス情報 | 利用シーン、閲覧環境の制約 |
| Why(なぜ) | 動機の推定 | 遷移経路、前後の行動 | 課題の背景、意思決定プロセス |
| How(どのように) | 行動の質と深さ | 滞在時間、スクロール深度 | 真剣度、理解度、満足度 |
問いの立て方の例:ある製品ページの閲覧が急に増えたとき
- Who:どの属性の会員が増えたのか——特定の診療科か、職種か
- What:そのページ単体か、副作用情報などとセットで見られているか
- When:増えたのはいつからか、時間帯に偏りはあるか
- Where:デバイスから利用シーンを推定できるか
- Why:外部のきっかけ(学会、報道、ガイドライン改訂)と時期が重なっていないか
- How:滞在やダウンロードを伴う“深い”閲覧か、通過だけか
6つの問いに自社データで答えを埋めていくと、「閲覧が増えた」という数字が、「誰が、何をきっかけに、どんな構えで見ているか」という行動ストーリーに変わります。
4-3. 「データ→仮説→問い」への変換
データを眺めて終わるのではなく、「なぜこの行動が起きたのか?」という問いを立てることが、マーケティングにおける出発点です。たとえば、特定疾患のコンテンツが夜間によく閲覧されているとしたら、以下のような問いが生まれます:
- この疾患は夜間診療や救急と関係があるのか?
- 開業医が診療後にじっくり学習しているのか?
- 患者からの問い合わせが多く、準備のために見ているのか?
このように、データを“仮説生成の材料”として捉え、次の打ち手を導き出すプロセスに変換することが、施策の解像度を高める鍵になります。
4-4. 仮説検証のためのA/Bテスト設計
立てた仮説は、実験的に検証することで確度が高まります。
ペルソナ仮説を検証するA/Bテストの設計例
仮説:「深夜学習型の会員は、簡潔な要約コンテンツを好む」
| 要素 | パターンA(対照群) | パターンB(実験群) | 測定指標 |
|---|---|---|---|
| コンテンツ形式 | 詳細記事 | 要約版+詳細リンク | 完読率、滞在時間 |
| 配信時間 | 午前 | 夜間 | 開封率、クリック率 |
| 件名 | 「製品Aの詳細解説」 | 「5分で分かる製品A」 | 開封率 |
結果の欄に、あらかじめ書ける数字はありません。差が出れば仮説は次の設計に進み、差が出なければ仮説の方を修正します。検証は仮説を守るために行うものではなく、壊すために行うものです。
このように、データ分析→仮説→検証のサイクルを回すことで、ペルソナの精度が継続的に向上します。
4-5. 人の像に変換するための言語化力
“人の像”に変えるとは、単にプロファイルを言い換えることではなく、「状況」「動機」「感情」を含んだストーリーとして描くことを意味します。
たとえば、以下のような変換が有効です:
- ×「ページAの閲覧数が増加」
- ○「勤務医が昼休みにページAを読んでいる。限られた時間で診療方針を確認しようとしている」
このような言語化を通じて、チーム内でも“共感できるユーザー像”が共有され、施策が単なる数値改善で終わらず、ユーザー視点に立った価値提供につながります。
4-6. ストーリーテリングのためのナラティブ構造
データを人の物語に変換する際、以下の「ナラティブ構造」が使えます。記述例はいずれも架空の記入例です。実在の声のように読める書き方は避け、実データや実際のヒアリングが取れた箇所から順に置き換えていきます。
データ・ストーリーの3幕構成
| 構成要素 | 内容 | 記述例(架空) |
|---|---|---|
| 背景(Setup) | 人物と状況の設定 | 「地方都市で開業する内科医。日中は外来で埋まり、新しい治療法を学ぶ時間が取れない」 |
| 転機(Conflict) | 課題や変化の発生 | 「患者から新薬について質問され、十分に答えられなかった」 |
| 解決(Resolution) | サービスとの出会い | 「夜間に会員サイトで要点を把握し、翌日の診療に活かす——という行動を想定する」 |
このような物語構造を用いることで、チーム内でのペルソナ理解が深まり、「この人のために」という視点が共有されます。
4-7. データは「人間理解のプロセス」の入口
データは客観性のある出発点ですが、それだけで“理解”は完結しません。大切なのは、そこから何を想像し、どんな仮説を立て、どう試すかという“人間中心の思考プロセス”に持ち込むことです。
ペルソナ設計、シナリオ設計、タイミング設計、そして施策評価に至るすべてが、この「人の像」としての理解を基盤とします。
4-8. 実践ワークショップ:自社データでペルソナを作る
理論を実践に移すため、以下のワークショップ形式で自社のペルソナを構築してみましょう。
90分ペルソナ構築ワークショップ
準備物
- 直近3ヶ月の会員属性データ
- 行動ログ(アクセス時間、閲覧ページ、滞在時間)
- 模造紙、付箋、ペン
ステップ1(20分):データの可視化
- 属性別×時間帯別のヒートマップを作成
- よく閲覧されているコンテンツをリストアップ
- 気づいた傾向を付箋に書き出す
ステップ2(30分):セグメント発見
- 似た行動パターンをグルーピング
- 各グループに仮の名前をつける(例:「深夜学習型」「昼休み確認型」)
- グループごとの特徴を数値で確認
ステップ3(30分):ペルソナ作成
- 各セグメントを代表する1人の人物像を描く
- 名前、年齢、1日の流れ、困りごと、情報ニーズを記載
- 「この人が喜ぶコンテンツは?」を議論
ステップ4(10分):優先順位づけ
- ビジネスインパクト×ボリューム(会員数)でマッピング
- 注力すべきペルソナを数個に絞る
このワークショップを定期的に実施することで、組織全体のペルソナ理解が深まります。
定量データを「人」として見る。この姿勢こそが、すべてのデジタルマーケティング施策を“生きた”ものに変えていく出発点です。
5. 実装のための考え方と体制
5-1. 道具より先に決めること
ペルソナ分析に必要な道具は、カテゴリで考えれば十分です。アクセス解析、会員管理、データの置き場所、可視化、テストの仕組み——どの製品を選ぶかは、既存システムとの連携性と、運用する人が使い続けられるかで決まるもので、正解のブランド一覧はありません。
それより先に確認すべき要件はひとつです。会員属性と行動ログを、同じ会員IDで突き合わせられること。 属性は会員データベースに、ログはアクセス解析に、と別々のシステムに散らばったままでは、この記事で述べてきた「かけ合わせ」がそもそも始められません。道具の選定より、この結合をどこで実現するかの設計が先です。
5-2. 組織体制とスキルセット
ペルソナ分析を継続的に機能させるには、適切な役割分担が必要です。
ペルソナ分析チームの役割定義
| 役割 | 担当業務 | 必要スキル |
|---|---|---|
| データアナリスト | ログ抽出、集計・分析、セグメント発見 | データ抽出・統計・可視化 |
| マーケティングマネージャー | 仮説立案、施策設計、効果検証 | マーケ戦略、医療知識 |
| コンテンツストラテジスト | ペルソナ文書化、ストーリー構築 | ライティング、UX理解 |
| 学術担当 | 医学的妥当性確認、現場ヒアリング | 医学知識、現場理解 |
| IT/システム担当 | データ基盤整備、ツール連携 | システム設計、連携設計 |
小規模組織では、1人が複数役割を兼務することもありますが、最低でも「データ分析」と「医学的解釈」の2つの視点は必須です。
5-3. よくある実装の障壁と解決策
理論は理解できても、実装段階で躓くことがあります。
実装時の典型的な課題
| 課題 | 症状 | 解決策 |
|---|---|---|
| データが統合されていない | 会員DBとログが別システム | データ基盤の構築、または定期的なデータ結合処理 |
| スキル不足 | 分析担当者が抽出・集計を回せない | 外部パートナー活用、または画面操作で完結する仕組みの導入 |
| 承認プロセスが重い | 分析結果を施策に反映するまでに時間がかかる | 小規模テストの承認権限を現場に委譲 |
| 施策への反映が進まない | ペルソナ資料が眠ったまま | 定例でペルソナベースの議論を習慣化 |
| 効果が見えない | ペルソナ活用の成果が不明 | ペルソナ別の指標を定点観測する場を用意 |
最も重要なのは「完璧を目指さず、小さく始めて改善する」姿勢です。まずは1つのペルソナで1つの施策を試し、サイクルを回すことから始めましょう。
まとめ:データと人間理解の循環
会員属性と行動ログのかけ合わせによるペルソナ構築は、以下のサイクルで継続的に深化します。
データ駆動型ペルソナの進化サイクル
- 観察:行動データから傾向を発見する
- 解釈:属性と組み合わせて人物像を描く
- 仮説:そのペルソナに何が響くかを推測する
- 実験:コンテンツや配信を最適化して試す
- 測定:ペルソナ別の行動変化を定量化する
- 学習:成功・失敗から洞察を得て、ペルソナを更新する
このサイクルを回し続けることで、ペルソナは「作った瞬間に古くなる資料」ではなく、「進化し続ける戦略ツール」になります。
最後に:データの向こうにいる「人」を忘れない
どれだけ高度な分析ツールを使っても、どれだけ精緻なセグメントを作っても、向き合っているのは「医師」という人間です。
彼らは日々、患者の命と向き合い、限られた時間の中で最善の判断を下そうとしています。その真摯な姿勢に敬意を持ち、「この情報は本当に医師の役に立つのか?」「この施策は医師の時間を奪っていないか?」と自問し続けることが、データドリブンマーケティングの本質です。
データは手段であり、目的ではありません。データを「人の像」に変える力とは、結局のところ、相手への想像力と共感力に他ならないのです。